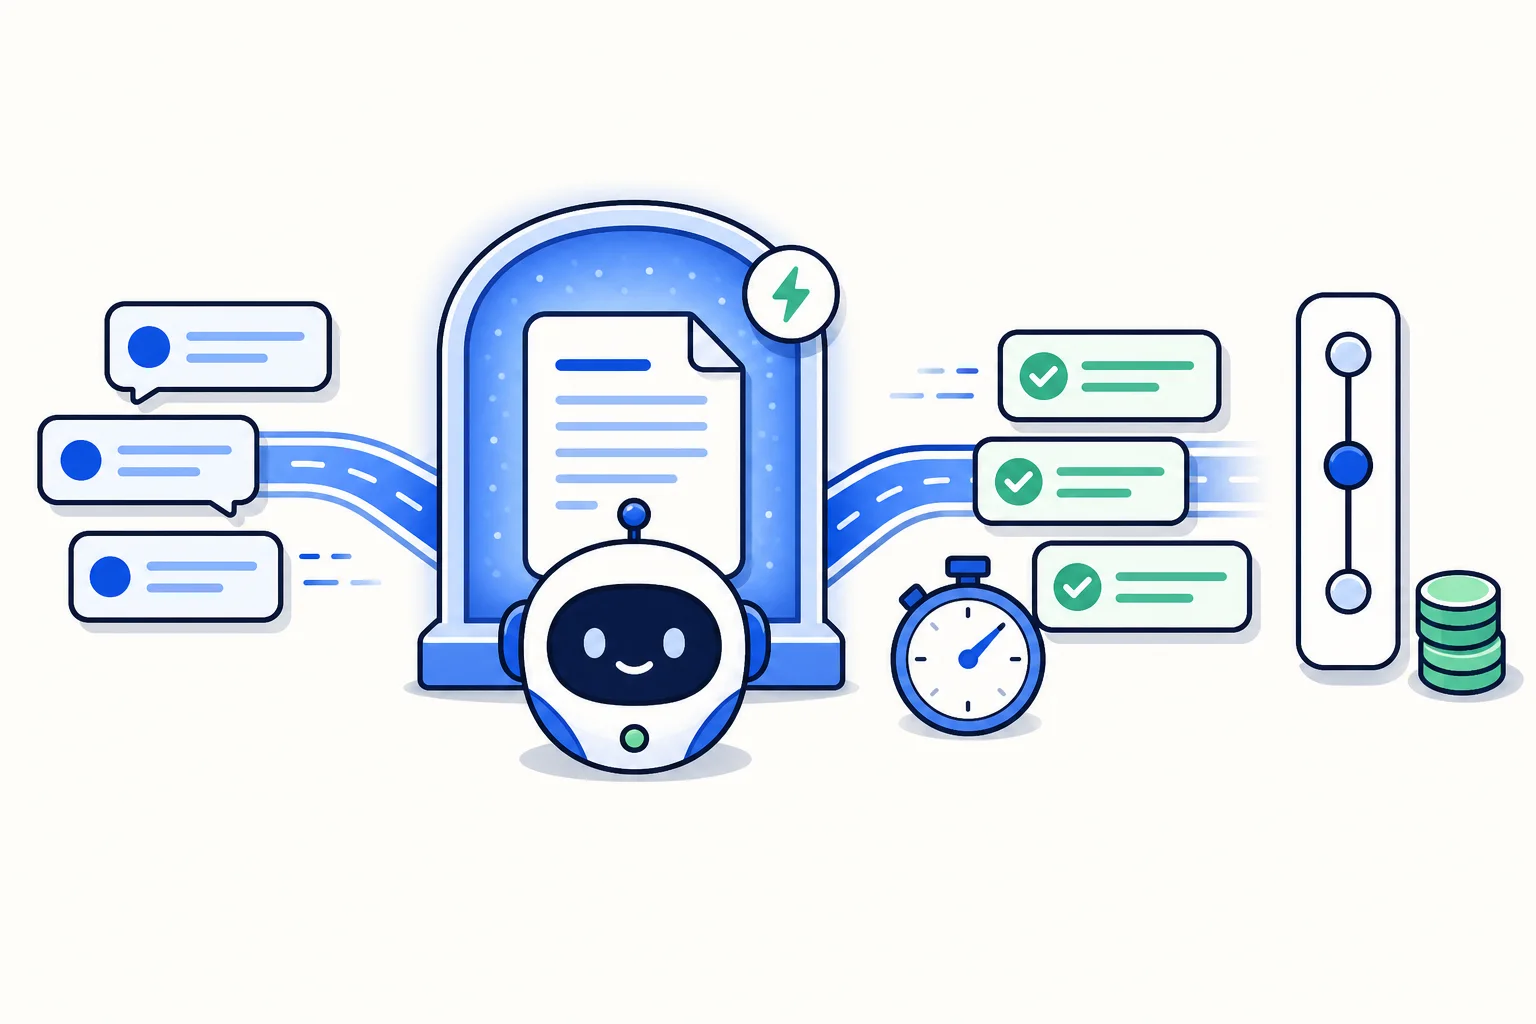
Cada respuesta que escribe un agente IA empieza con el mismo preámbulo largo: quién es el agente, cómo debe sonar, qué sabe del negocio, qué no debe hacer nunca. Ese prompt de sistema puede llegar a miles de tokens, y hasta ahora el modelo lo leía desde cero en cada mensaje. HellouOne lanzó dos cambios que atacan ese desperdicio de frente. El prompt de sistema de cada agente IA ahora se guarda en caché con el proveedor del modelo (Gemini), y la cantidad de esfuerzo de razonamiento que un agente dedica a cada respuesta es ajustable. El resultado son respuestas más baratas y más rápidas sin cambiar lo que el agente dice.
Cómo funciona la caché de prompts
Un modelo de lenguaje se factura y se cronometra por los tokens que procesa. Cuando los primeros miles de tokens de una solicitud son idénticos de una llamada a la siguiente, el proveedor puede conservar su forma procesada en una caché y saltarse ese trabajo la segunda vez. El modelo sigue viendo el prompt completo; solo deja de pagar por releer la parte que no cambió. Eso es la caché de prompts, y solo ayuda si la parte repetida es realmente idéntica en cada llamada.
Esa última condición es donde ocurrió la ingeniería de verdad. HellouOne solía colocar el contexto de cada turno, como los detalles de la conversación en curso, dentro del mensaje de sistema. Cada turno hacía el mensaje de sistema un poco distinto, así que la caché nunca acertaba. El contexto por turno ahora se movió fuera del mensaje de sistema en caché, a la parte de la solicitud que se espera que cambie. La parte estable se mantiene estable, la caché acierta en cada respuesta después de la primera, y el agente se comporta exactamente igual que antes.
Qué cambia en velocidad y costo
Menor costo por respuesta. La porción en caché del prompt se factura a una tarifa reducida por el proveedor, y en agentes con mucho conocimiento en el prompt de sistema esa porción es la mayor parte de la solicitud.
Menor latencia. Saltarse el reprocesamiento del prompt de sistema acorta el tiempo hasta el primer token, que el cliente percibe como una primera respuesta más rápida.
Sin cambio de comportamiento. El agente lee las mismas instrucciones y el mismo conocimiento. La caché cambia cómo se procesa la solicitud, no lo que contiene.
Se multiplica con el volumen. Una línea que atiende miles de conversaciones al día repite el mismo prompt de sistema miles de veces; ese es justo el caso para el que se diseñó la caché.
Esfuerzo de razonamiento, por agente
El segundo cambio es un dial. El esfuerzo de razonamiento controla cuánto piensa el modelo antes de responder. Más esfuerzo puede ayudar en preguntas realmente difíciles; en el mensaje típico de un cliente, que es una pregunta sobre horarios, un precio o un pedido, sobre todo agrega tiempo y costo. HellouOne ahora define el esfuerzo de razonamiento por agente IA, bajo por defecto, y te permite cambiarlo en el editor del agente o pidiéndoselo a LIA. Un agente de ventas que maneja negociaciones con matices puede correr con un ajuste más alto; un agente de recepción que responde las mismas veinte preguntas todo el día se queda en bajo y responde más rápido por menos.
Por qué importa para el presupuesto
Los mensajes de IA se miden en los planes de HellouOne, y el costo del modelo detrás de ellos es lo que define esos límites con el tiempo. La caché y el dial de esfuerzo bajan el costo de servir cada respuesta, que es lo que hace sostenibles las cuotas generosas de mensajes de IA y mantiene el precio por mensaje muy por debajo de alternativas comparables. Para el negocio, significa que el agente IA puede asumir más volumen de conversaciones con el mismo presupuesto, y responder más rápido mientras lo hace.
Cómo usarlo en HellouOne
La caché está activa para todos los agentes IA; no hay nada que habilitar. Lo que vale la pena es mantener estable el prompt de sistema: pon el conocimiento que rara vez cambia en el prompt o en la base de conocimiento del agente, y deja los detalles de cada cliente a la conversación, que es como está organizado el editor. Para el esfuerzo de razonamiento, abre el agente en el editor o pídele a LIA que muestre el ajuste actual. Déjalo en bajo para trabajos de alto volumen y bien definidos. Súbelo para un agente cuyas conversaciones requieren criterio, y observa el tiempo de respuesta y el uso de mensajes de IA en Reportes después del cambio. Como con toda edición de un agente, LIA propone el cambio y tú lo apruebas, y el nuevo ajuste se convierte en una versión a la que puedes volver.