El 15 de septiembre de 2026, TypeSafe AI, una empresa de San Francisco fundada por el exinvestigador de OpenAI Diogo Almeida junto con Erik Gafni y Sasha Sheng, abrió el acceso anticipado a Jev, al que llama el primer modelo System One. El lanzamiento llegó con cerca de 40 millones de dólares de financiación y un hilo que alcanzó decenas de millones de vistas en días. La atención se entiende, porque Jev es un tipo distinto de modelo. No escribe nada. Decide.
Un modelo que responde preguntas en vez de escribir texto
Un modelo de lenguaje grande genera texto token por token. Eso es lo que lo hace bueno para escribir una respuesta, resumir un documento o redactar un correo. También es lo que lo convierte en una herramienta incómoda para una pregunta como: este mensaje es una consulta de ventas o una solicitud de soporte? Para obtener la respuesta, le pides al LLM que escriba la respuesta, luego interpretas las palabras que produjo y esperas que coincidan con el formato que pediste.
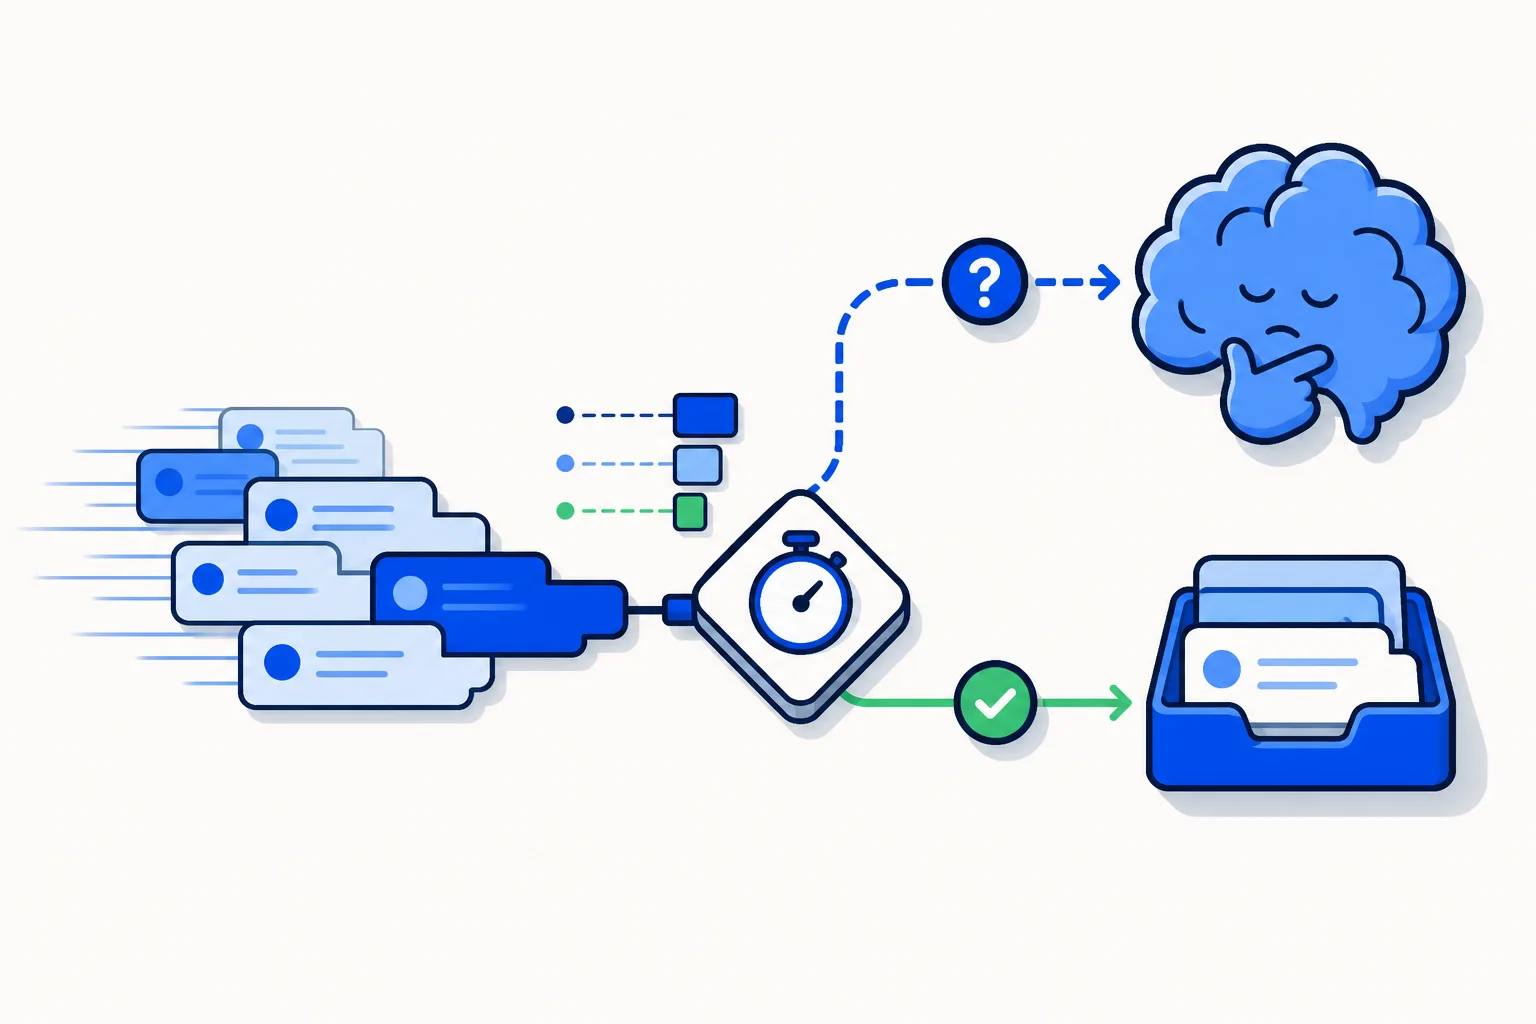
Jev se salta la escritura. Le envías un estado, que puede ser texto plano o JSON, más una o varias preguntas tipadas, y devuelve respuestas tipadas directamente. TypeSafe expone tres primitivas: Choice elige una opción de una lista, Score califica algo según un criterio y Noul responde verdadero o falso. Cada respuesta llega con una probabilidad calibrada, así tu código sabe no solo qué eligió el modelo sino qué tan seguro está. Todas las preguntas de una solicitud se evalúan en una sola pasada, y como no se genera nada, la salida no puede venir mal formada.
Los números detrás del lanzamiento
Precio: 0.042 dólares por millón de tokens de entrada. La salida es gratis, porque no hay tokens de salida que cobrar.
Latencia: de 70 a 500 milisegundos de extremo a extremo, suficiente para vivir dentro de una solicitud en vez de detrás de una cola.
Entrenamiento: un método que TypeSafe llama Reinforcement Learning for Calibrated Decisions, o RLCD, orientado a que las probabilidades signifiquen lo que dicen.
Nombre: un guiño a William Stanley Jevons, el economista detrás de la paradoja de Jevons, según la cual cuando baja el costo de un recurso aumenta su uso total. System One se refiere al pensamiento rápido e intuitivo, en contraste con la deliberación lenta.
Los análisis independientes publicados desde el lanzamiento reportan una precisión en tareas de clasificación comparable a la de los LLM de frontera, a una fracción pequeña del costo por decisión. Como con cualquier modelo nuevo, lo correcto es probarlo con tus propios datos, pero la forma de la afirmación es consistente en toda la cobertura: un modelo estrecho, muy rápido y muy barato en lo único que hace.
Cómo está pensado para usarse
TypeSafe no posiciona a Jev como reemplazo de un modelo de lenguaje grande. El patrón recomendado es ponerlo delante de uno. Jev se encarga de la primera pregunta sobre cada entrada: qué es esto, qué tan urgente es, por qué camino debe ir, es seguro automatizarlo. Cuando la confianza es alta, el sistema actúa directamente sobre esa respuesta. Cuando la confianza es baja, la entrada se escala a un modelo grande, o a una persona, con la incertidumbre adjunta. El modelo caro y lento se reserva para los casos que lo necesitan.
Ese patrón le resulta familiar a cualquiera que haya construido un agente IA de soporte o de ventas. La parte difícil nunca fue escribir la respuesta. Fue decidir, rápido y de forma confiable, qué tipo de conversación es esta y qué debe pasar después.
Qué significa para la atención al cliente con IA
Los negocios que atienden conversaciones con IA en WhatsApp, chat web o correo toman cientos de decisiones pequeñas por hora que no tienen que ver con escribir. Aquí es donde un modelo de decisión cambia la economía:
Enrutamiento más rápido. Decidir si un mensaje nuevo pertenece a ventas, soporte o facturación, y qué equipo o agente IA debe tomarlo, puede ocurrir en mucho menos de un segundo y antes de redactar cualquier respuesta.
Clasificación más barata. Etiquetar cada conversación entrante por intención, idioma, sentimiento o urgencia costaba una llamada completa al LLM cada vez. A fracciones de centavo por millón de tokens de entrada, etiquetar todo pasa a ser lo normal y no un ejercicio de muestreo.
Automatización con confianza. Las probabilidades calibradas permiten que un agente IA actúe por su cuenta solo cuando está seguro, y traspase a una persona, con contexto, cuando no lo está. Esa es la diferencia entre una automatización que los clientes toleran y una en la que confían.
Controles sobre las acciones. Antes de que un agente IA cree un ticket, comparta un enlace de pago o reserve un horario, una verificación de sí o no con un puntaje de confianza es un lugar barato para atrapar errores.
Una forma práctica de pensarlo
Imagina la línea de WhatsApp de una clínica. Cada mensaje pasa primero por una capa de decisión: es una solicitud de cita, una pregunta de precios, una queja u otra cosa; está en español o en inglés; es urgente. Las solicitudes de cita con alta confianza van directo al flujo de reserva. Las preguntas de precios van al agente de IA que conoce la lista de precios. Las quejas y todo lo incierto van a una persona con la clasificación adjunta. El modelo grande sigue escribiendo las respuestas que necesitan escribirse. Simplemente deja de ser el que hace la clasificación.
Esta es la dirección en la que se mueve todo el campo: menos llamadas monolíticas, más pasos pequeños y bien definidos, cada uno a cargo de la herramienta que mejor lo hace. HellouOne ya funciona así a nivel de producto, con un agente de IA que responde primero y escala a una persona con contexto cuando hace falta. Modelos como Jev hacen que los pasos de decisión debajo de ese tipo de sistema sean más rápidos, más baratos y más medibles, y eso es una buena noticia para todo negocio cuyos clientes viven en una ventana de chat.